
De segment methode
De gegevens in het datawarehouse worden opgeslagen op een spoortakmodel agnostische manier. Elk record in het datawarehouse is gekoppeld aan een locatie en een tijdstip. Het grootste probleem bij het opslaan van gegevens voor lineaire assets is dat deze lineaire assets in de loop van de tijd veranderen. Bij het verwijderen van een wissel kunnen bijvoorbeeld twee sporen worden samengevoegd, of bij het plaatsen van een wissel kan een enkel spoor worden gesplitst. Bij het samenvoegen of splitsen van een spoor blijft het grootste deel van het spoor ongewijzigd. Alle gegevens die voorheen aan dit spoor waren gekoppeld, horen nu plotseling bij een volledig andere locatie en moeten dus opnieuw worden gelabeld.
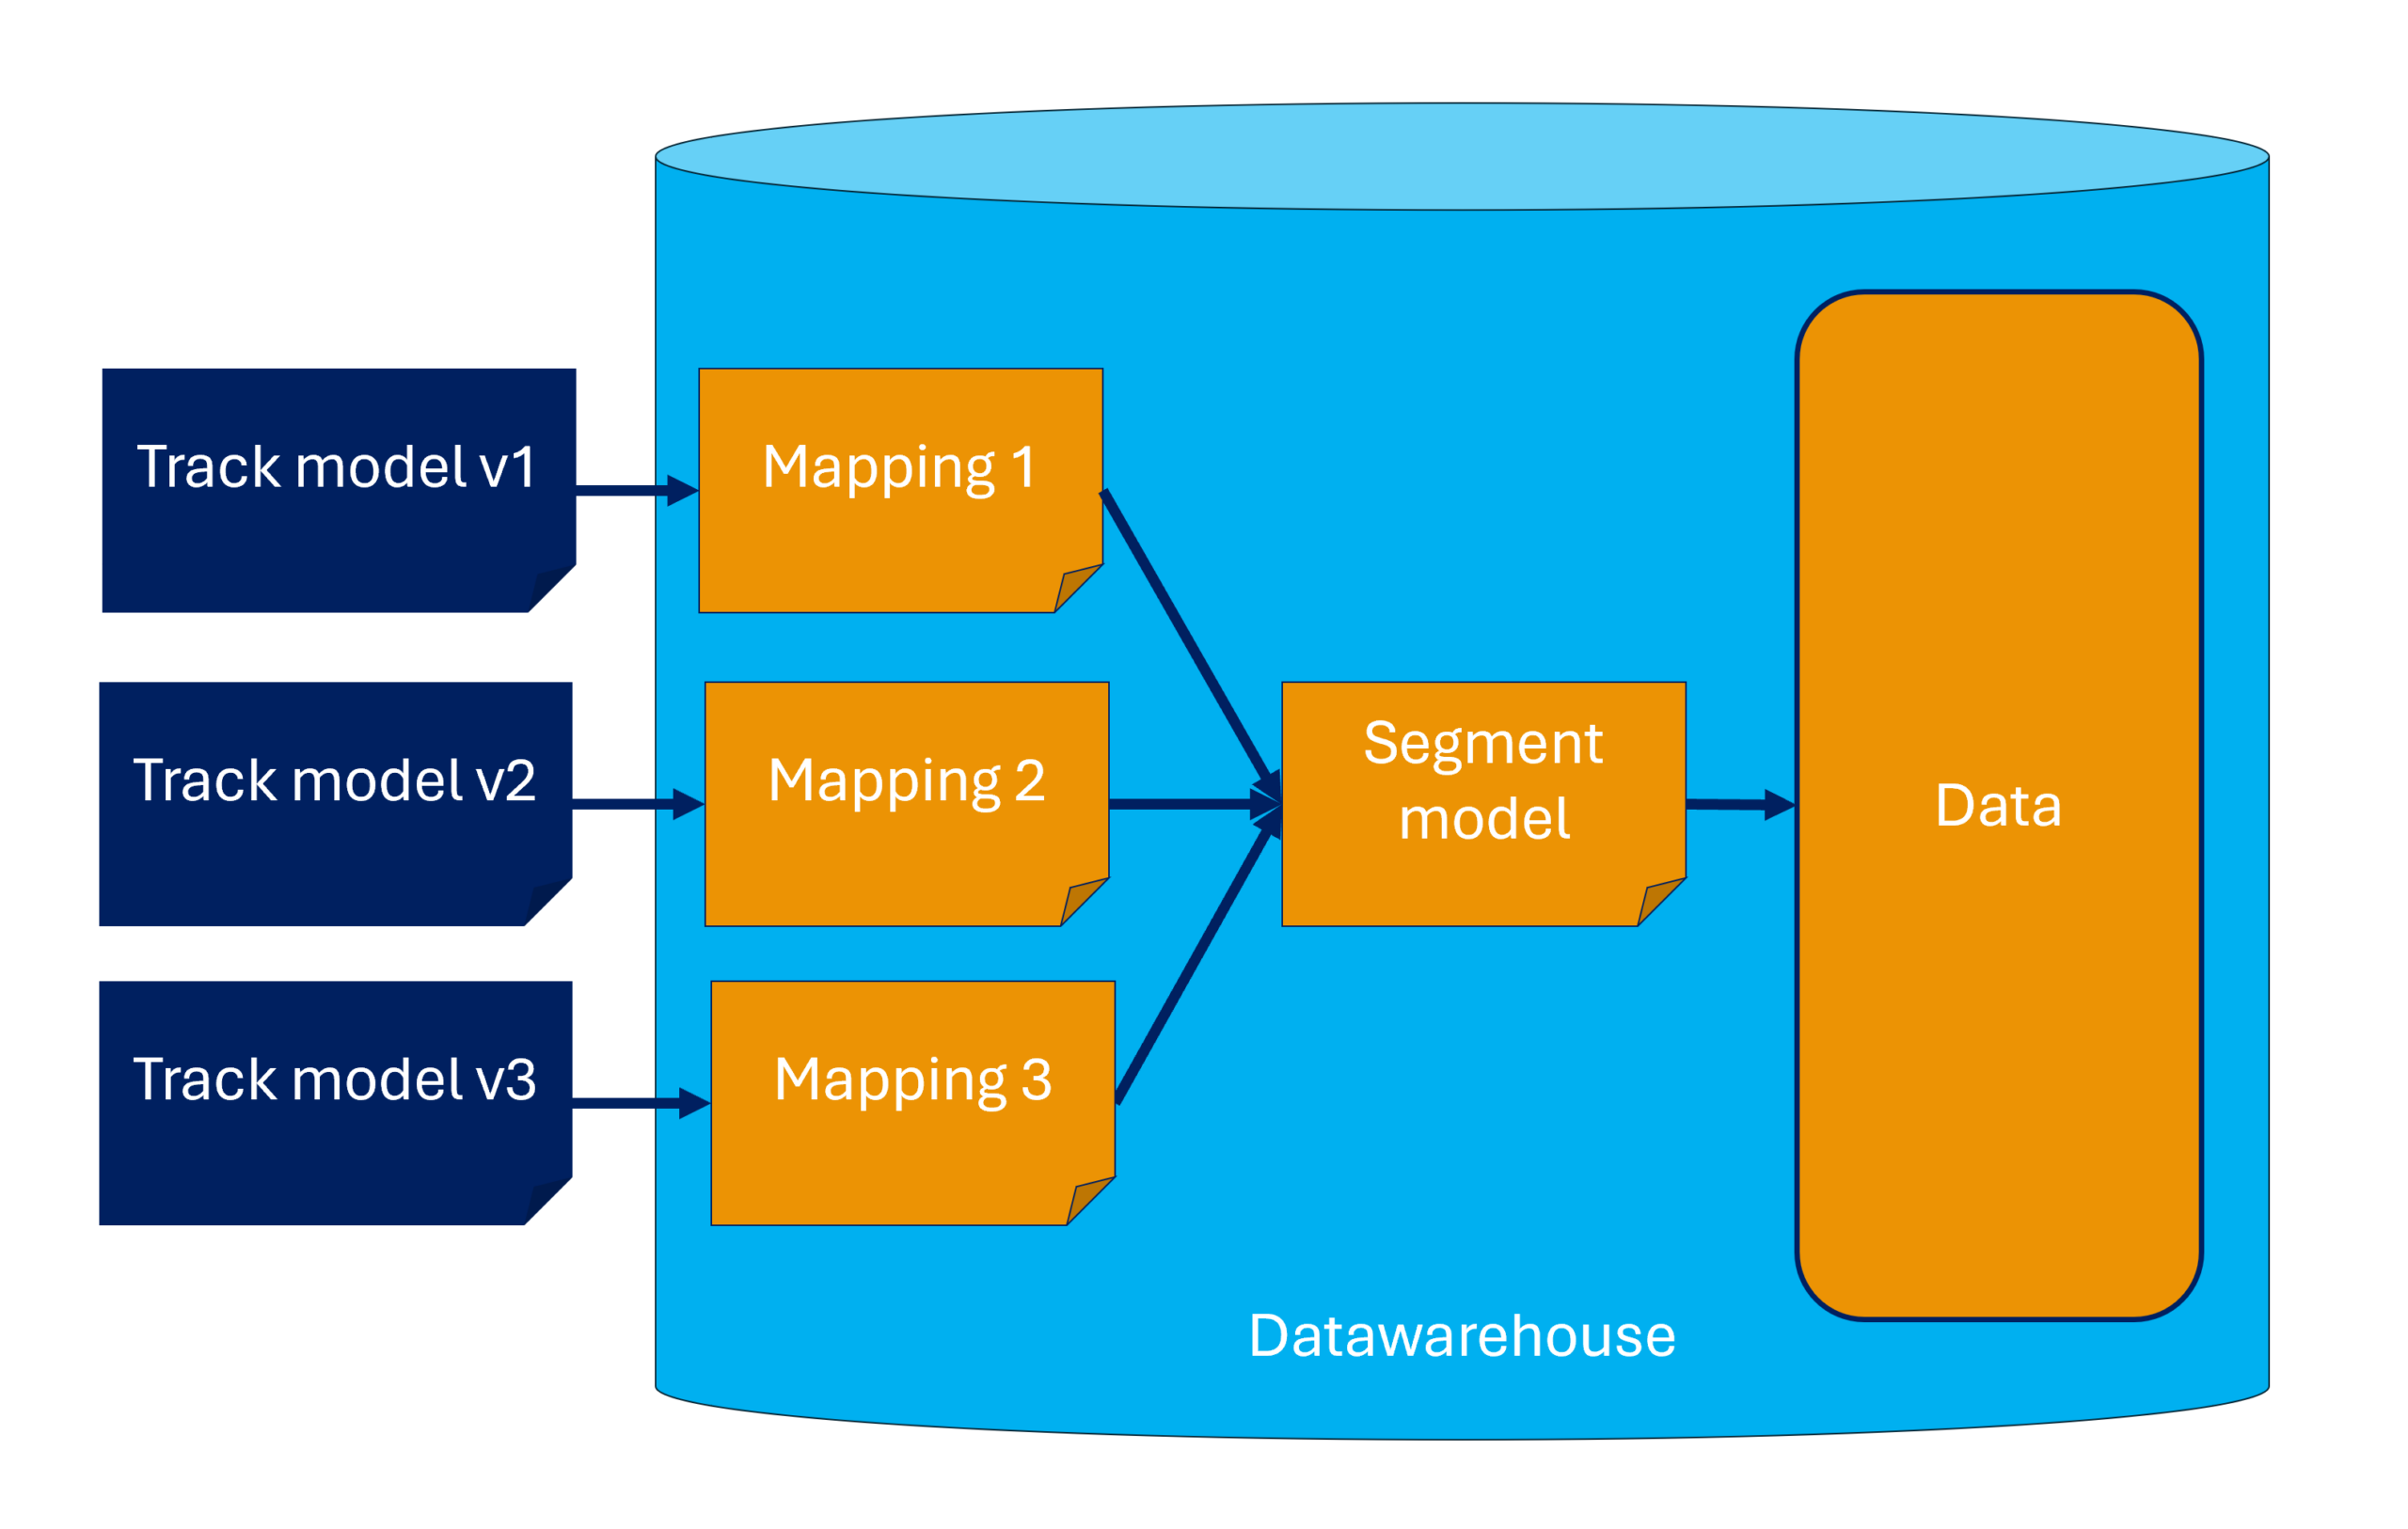
In plaats van alle gegevens opnieuw te labelen, implementeert RailDB de segmentatie methode. Elke spoortak van het spoortakmodel wordt opgesplitst in korte segmenten van ongeveer 1 meter lang. Deze segmenten krijgen een uniek segment ID. Bij het importeren van nieuwe gegevens in het datawarehouse worden de gegevens niet gelabeld met het huidige spoortak ID, omdat dit in de loop van de tijd kan veranderen. In plaats daarvan worden de gegevens gelabeld met de segment ID’s door gebruik te maken van een mapping van het huidige spoortakmodel naar het segmentmodel.
Door deze methode toe te passen, hoeven de opgeslagen gegevens nooit opnieuw te worden gelabeld. In plaats daarvan wordt voor opeenvolgende versies van het spoormodel een nieuwe mapping van het nieuwe spoortakmodel naar het bestaande segmentmodel gemaakt. Dit principe wordt getoond in de onderstaande afbeelding. Zoals u kunt zien, heeft het segmentmodel geen versies. Dat is ook niet nodig.
Gegevens importeren
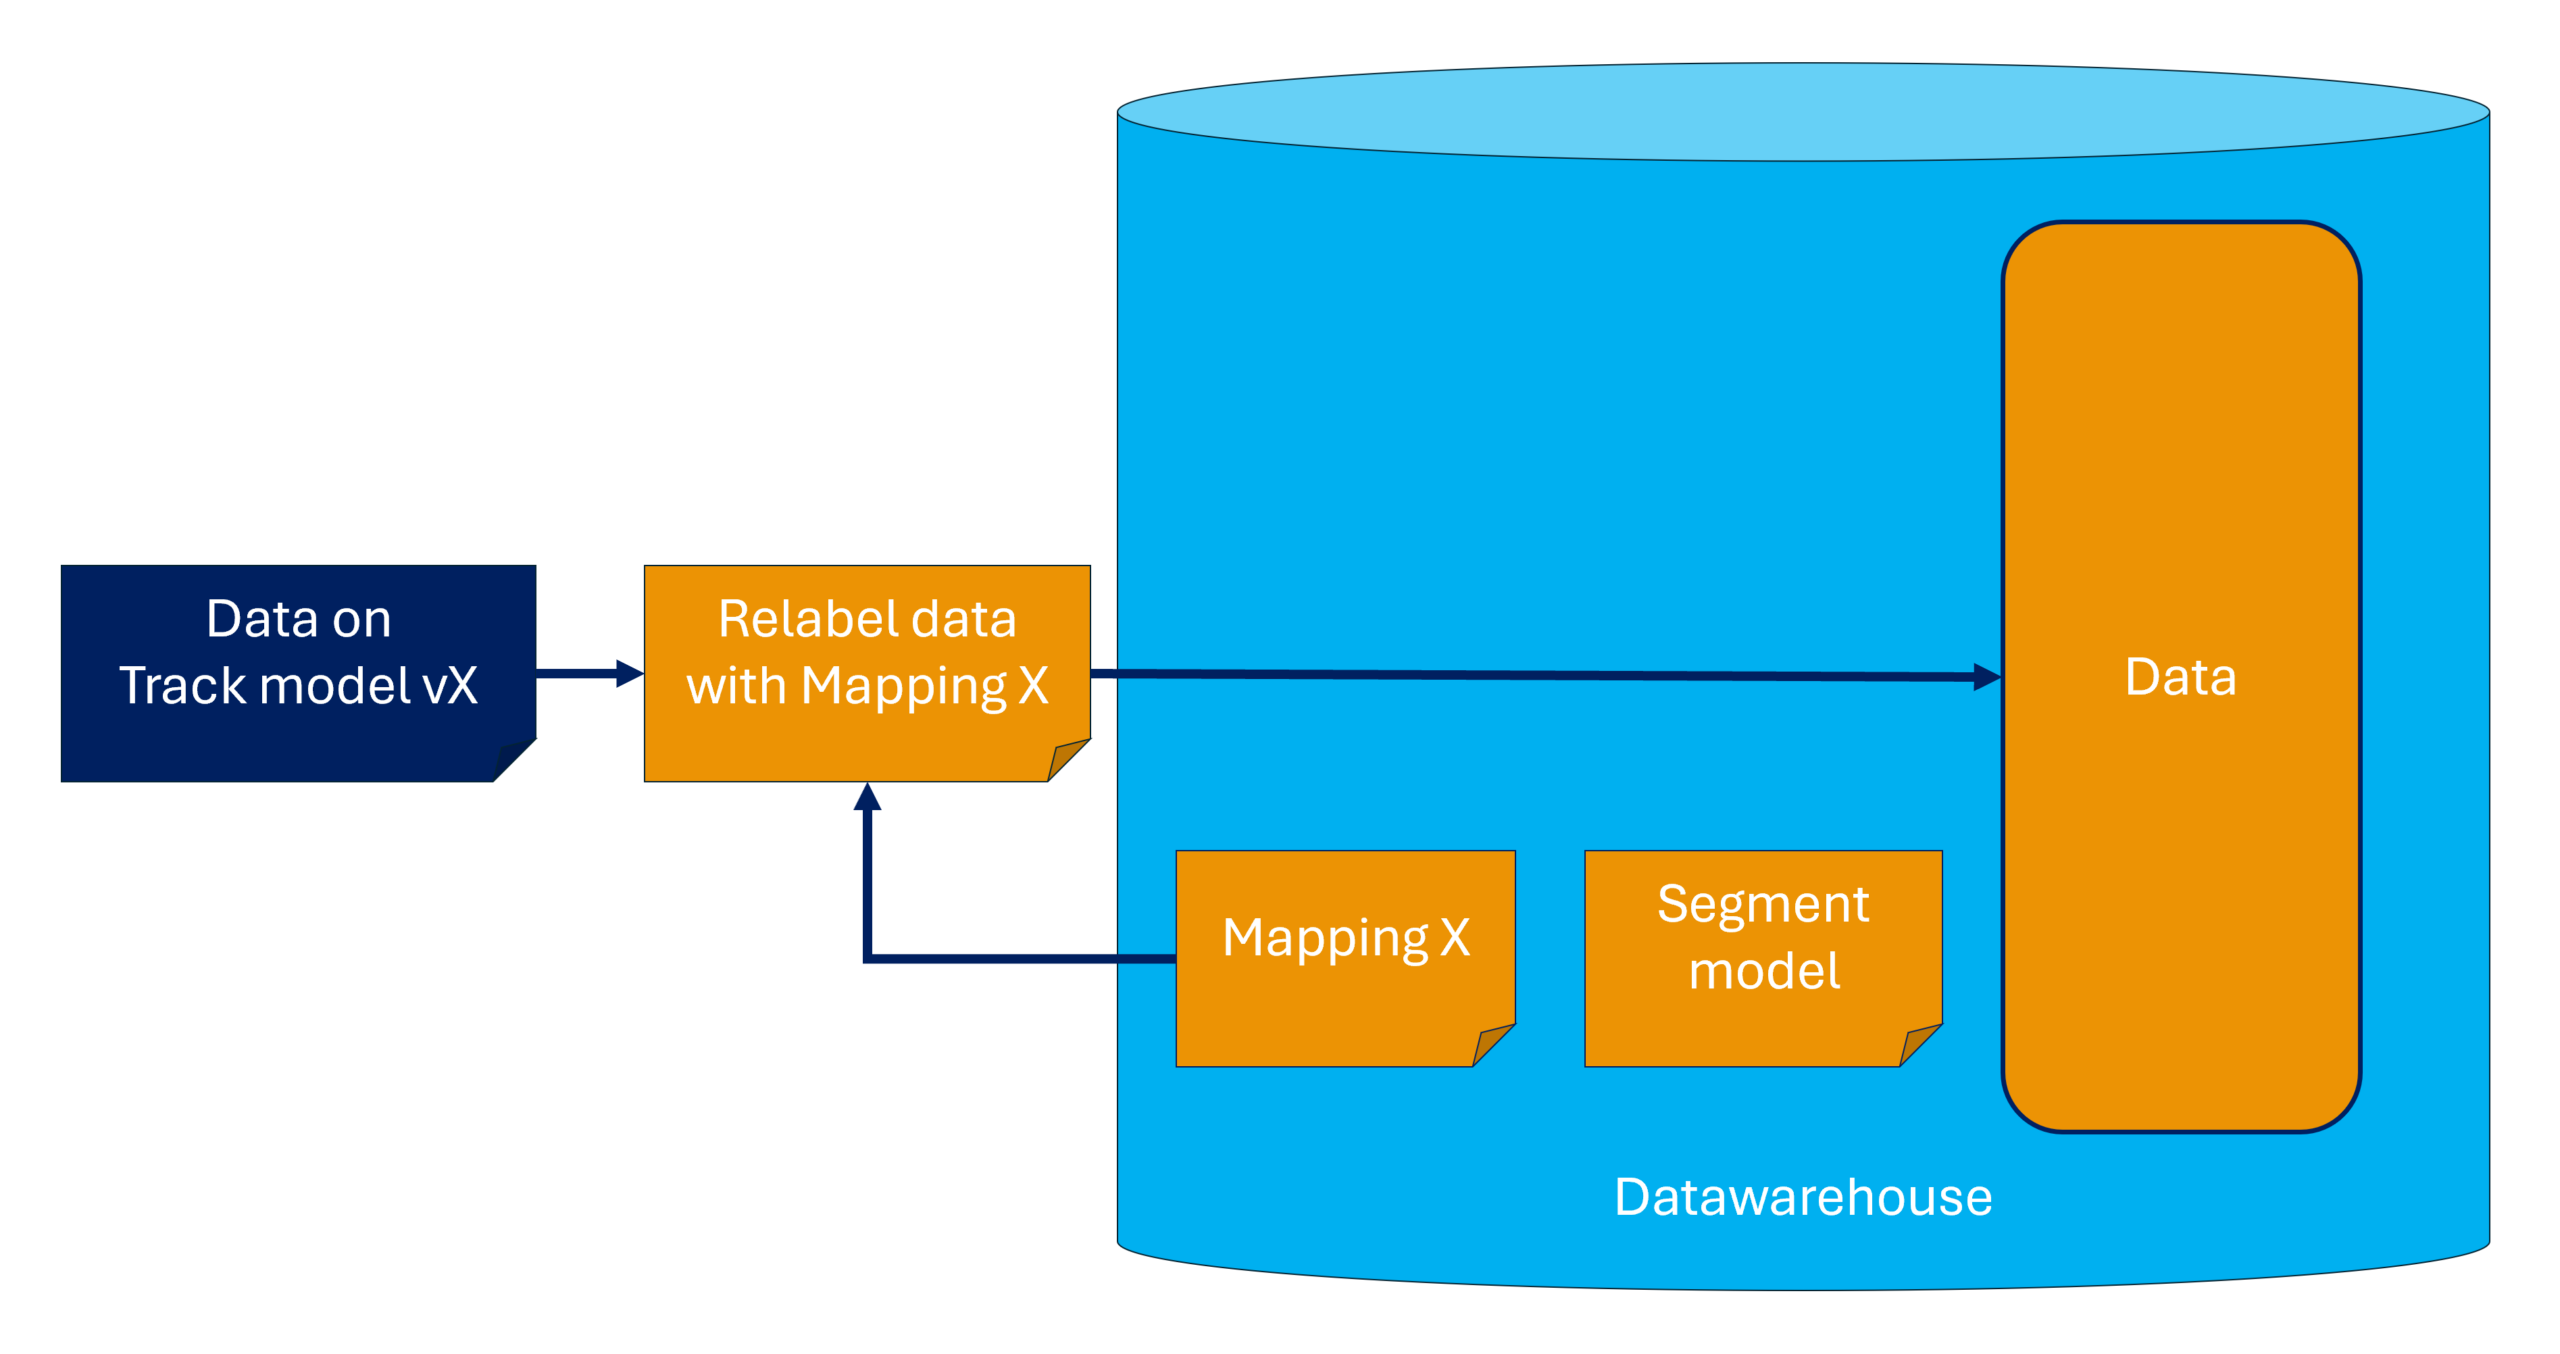
Hoe werkt het importeren van gegevens in het datawarehouse dan? Dit proces wordt hier getoond. Stel dat de gegevens zijn gelabeld op spoortakmodel versie X. De mapping van spoortakmodel X naar segmenten wordt toegepast en de gegevens worden opnieuw gelabeld met segment ID’s. Vervolgens worden de gegevens in het datawarehouse geïmporteerd.
Gegevens exporteren
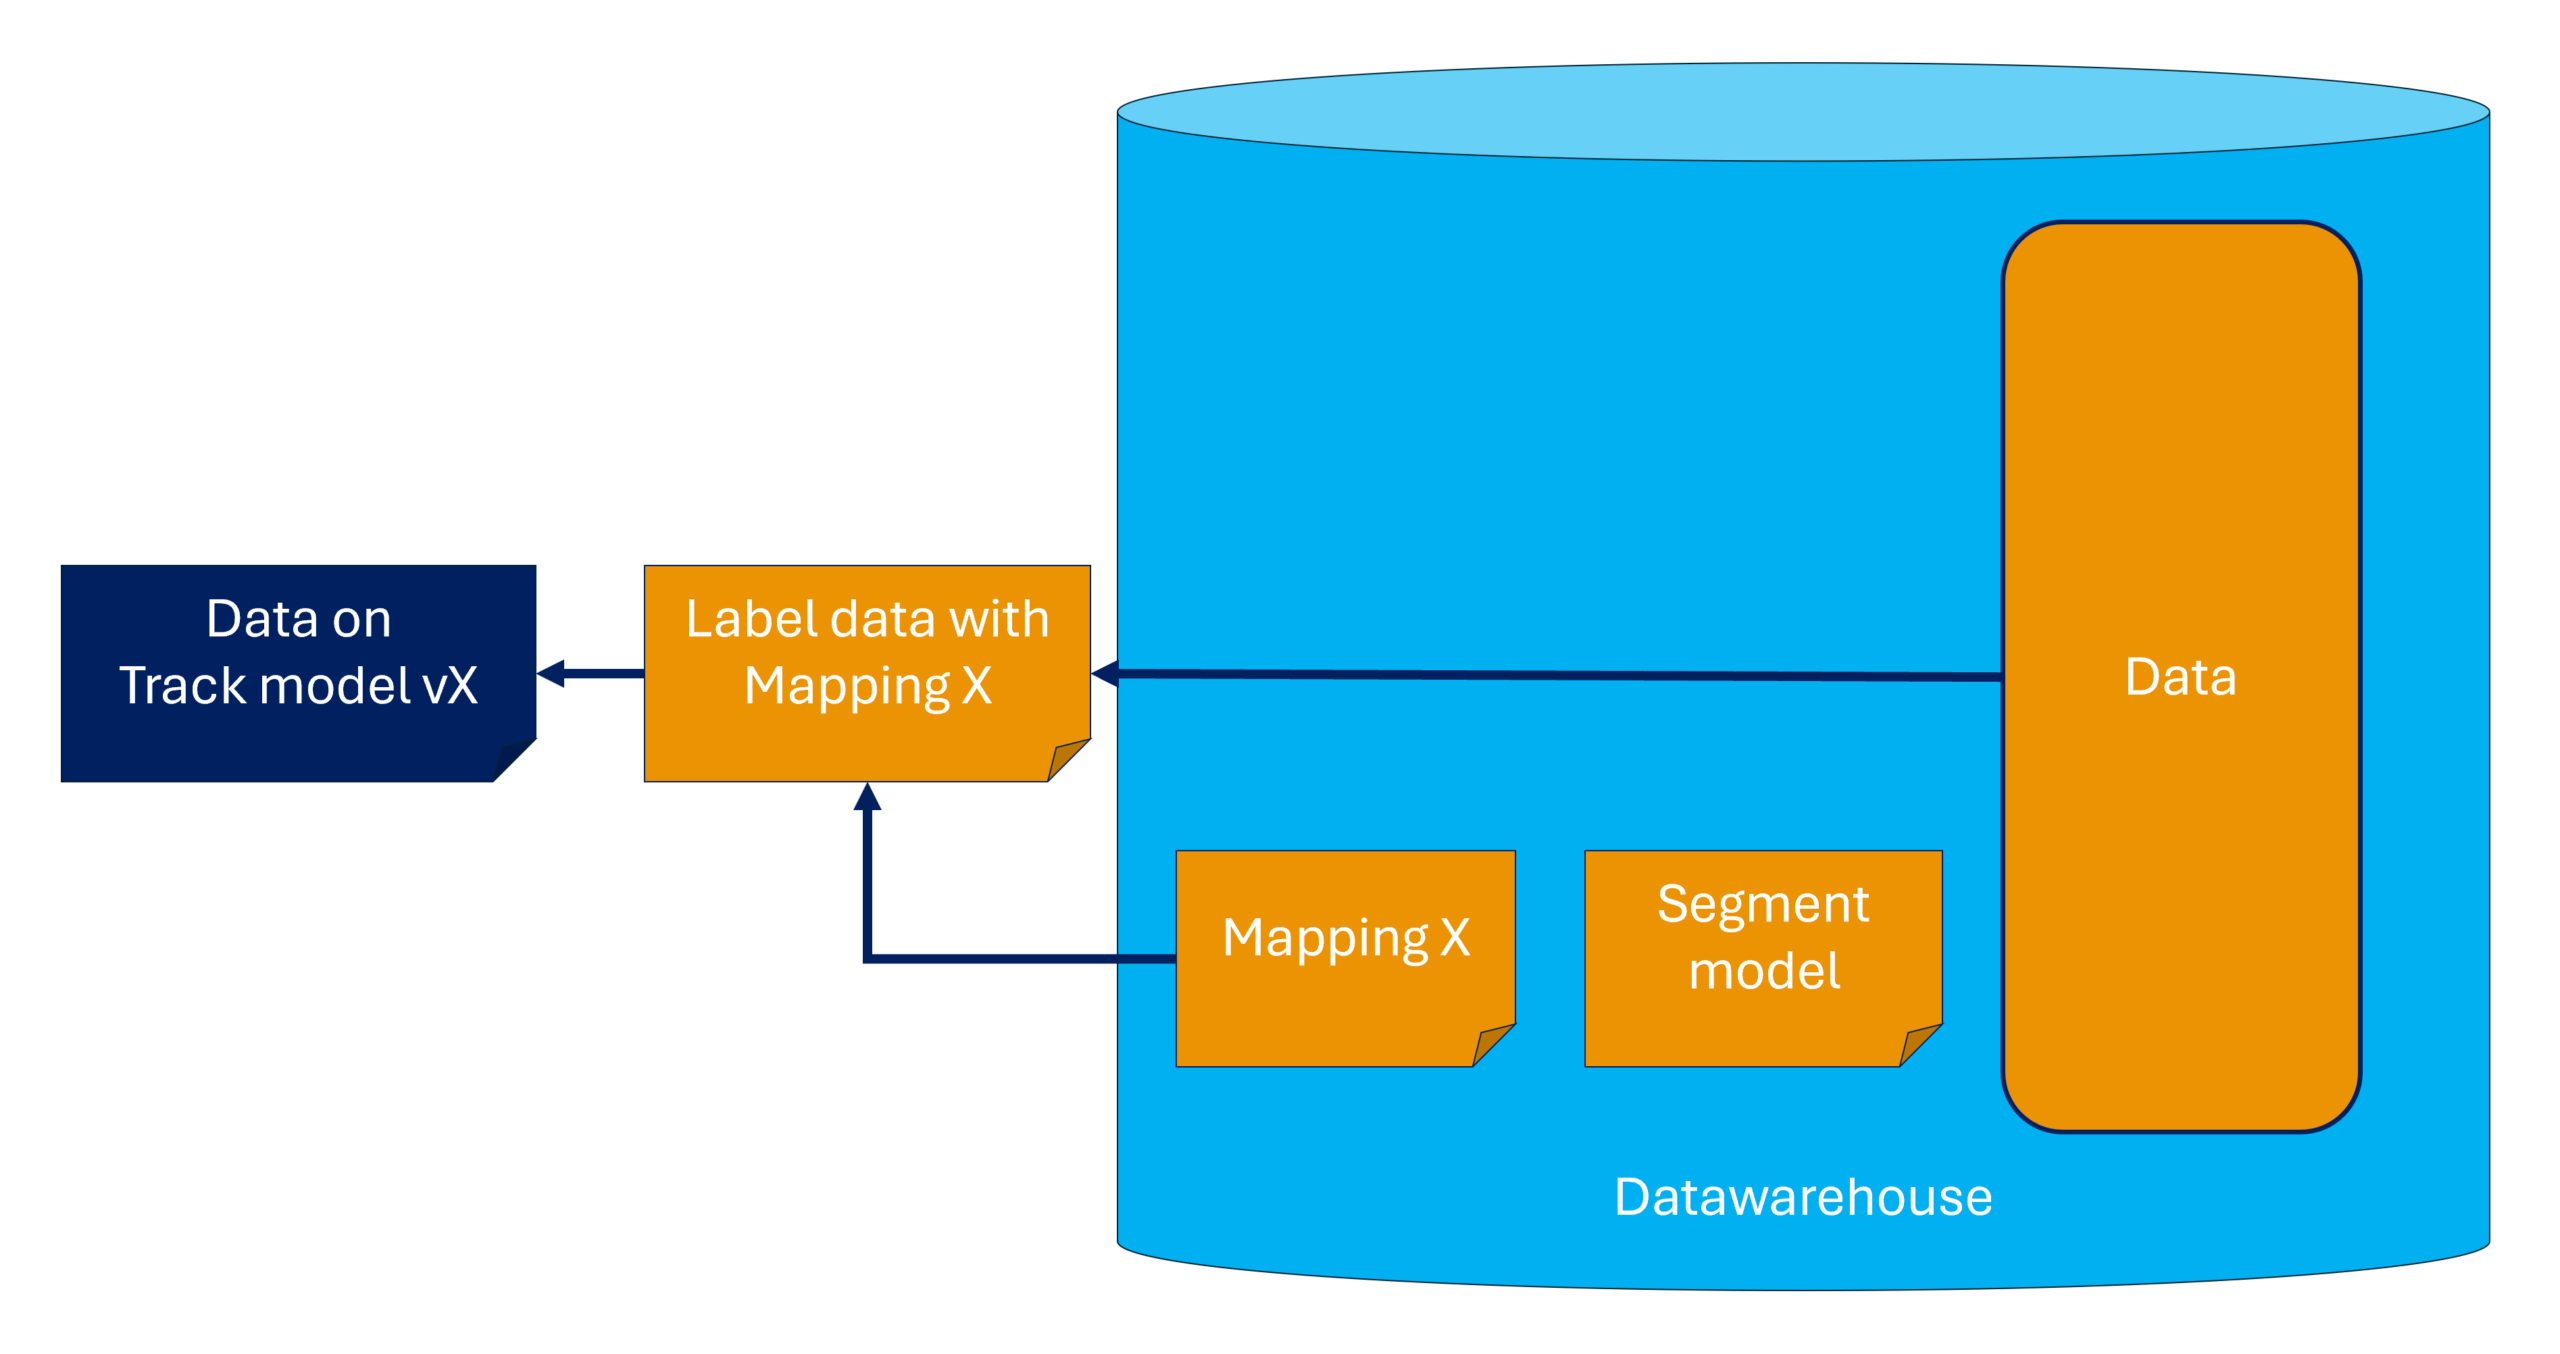
Het exporteren van de gegevens werkt precies andersom; het proces wordt hier getoond. Stel dat de gegevens moeten worden gelabeld op spoortakmodel versie X. De mapping voor versie X wordt dan toegepast om de gegevens om te labelen van segmenten naar spoortakken. Dit kan uiteraard alleen worden gedaan voor de segmenten die spoortakken vertegenwoordigen dat bestaat binnen versie X van het spoormodel. Vervolgens halen we de gegevens uit het datawarehouse.
Updates van het spoortakmodel
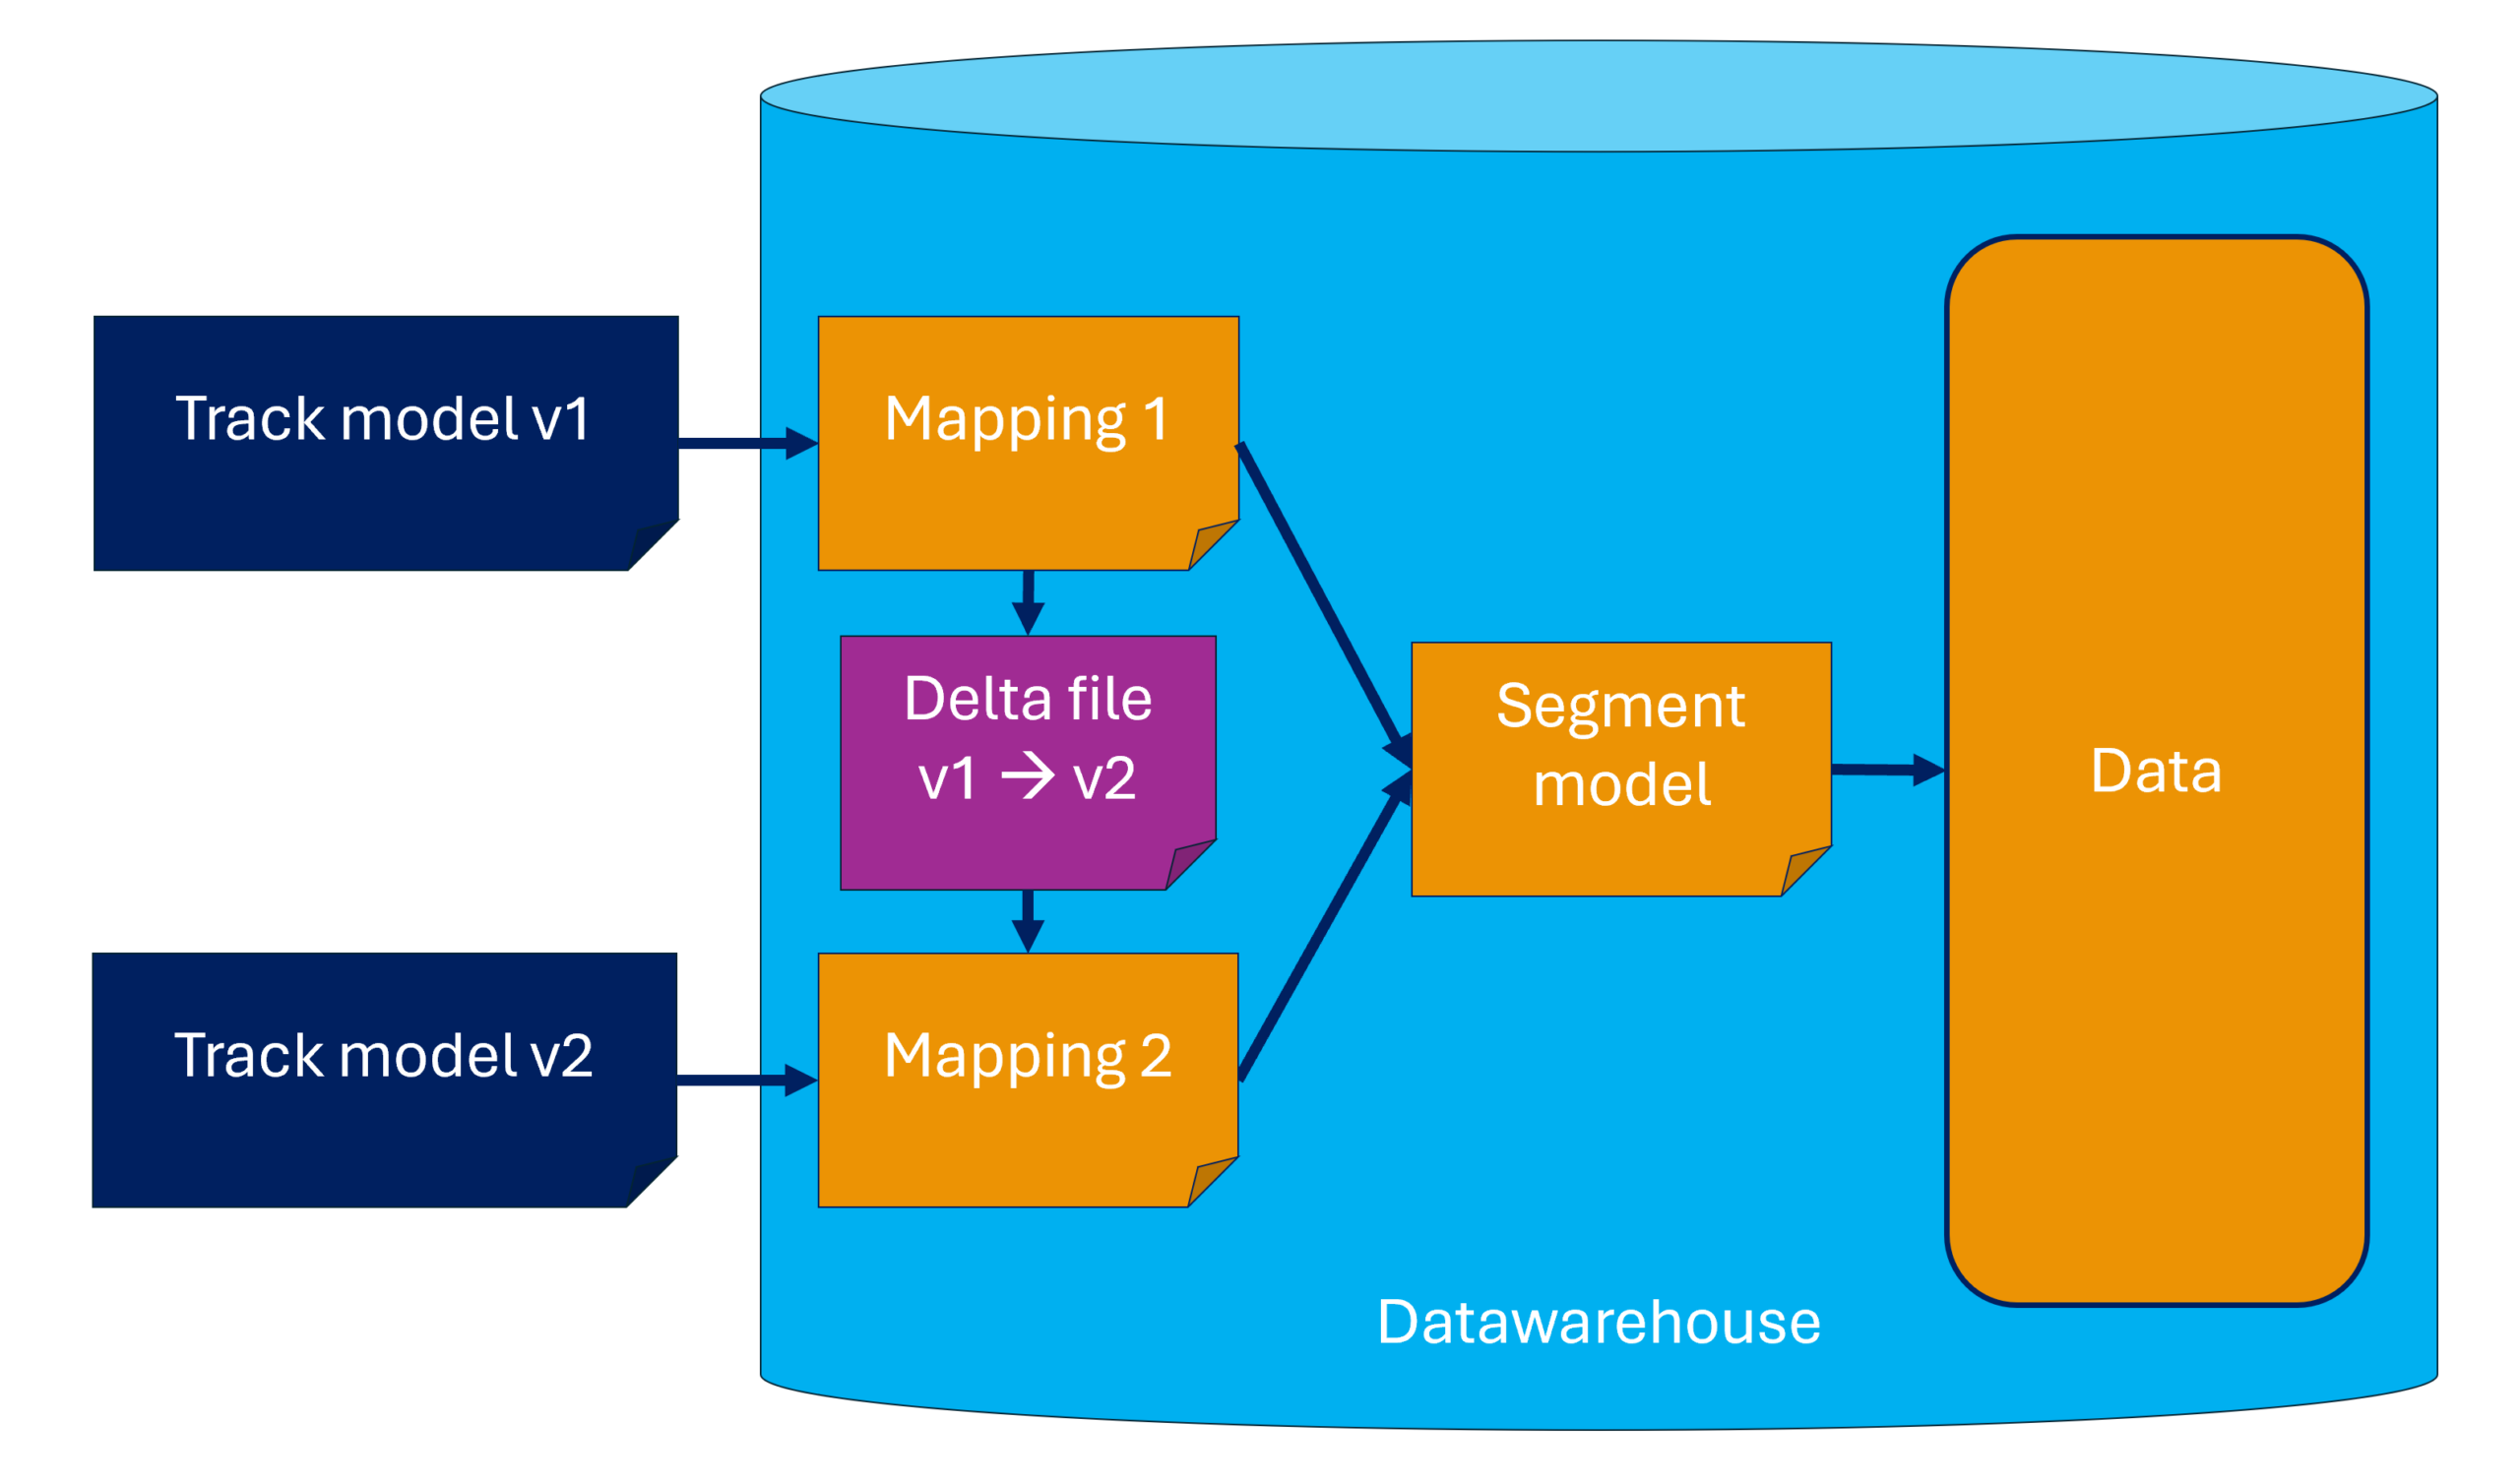
Wanneer het spoortakmodel wordt bijgewerkt, moet er een nieuwe mapping worden gemaakt van het nieuwe spoortakmodel naar het bestaande segmentmodel met behulp van een delta-bestand. Het delta-bestand is een mapping tussen opeenvolgende versies van een spoortakmodel en is vereist om mapping versie X te vertalen naar mapping versie X+1. Dit proces wordt hier getoond; overweeg de volgende scenario’s voor het hermappen van de gegevens:
- Er worden nieuwe sporen toegevoegd: er worden nieuwe segmenten aan het segmentmodel toegevoegd. Deze segmenten zullen niet aanwezig zijn in oudere mappings, maar wel in alle nieuwere mappings.
- Sporen worden verwijderd: de verwijderde segmenten zullen niet langer aanwezig zijn in de nieuwere mappings, maar ze blijven wel aanwezig in oudere mappings. Oude gegevens gaan dus nooit verloren, ze zijn alleen niet langer toegankelijk via nieuwere versies van het spoortakmodel.
- Sporen worden samengevoegd of gesplitst: in nieuwere mappings zullen dezelfde segmenten van voorheen nu simpelweg verwijzen naar andere sporen. Het grote voordeel hier is dat door de korte segment lengtes de lineaire referentie van de gegevens op de segmenten niet verandert. Er hoeven dus wederom geen gegevens opnieuw te worden gelabeld.